Ценность каталога данных определяется тем, насколько полно он видит реальный ИТ-ландшафт компании: базы данных, аналитические хранилища, BI-платформы, процессы загрузки, объектные хранилища, ML-сервисы и корпоративные приложения. Если часть систем остаётся за его пределами, то карта данных получается неполной, а поиск источников, анализ зависимостей и работа с владельцами данных превращаются в ручное исследование.
Соединить Arenadata Catalog (ADC) с источниками данных помогают коннекторы. Они автоматически собирают метаданные, приводят их к единой модели и позволяют увидеть, как технические объекты связаны друг с другом, отчётами, бизнес-терминами и ответственными сотрудниками. В результате своей работы коннектор переводит внутреннее устройство конкретной системы на язык каталога данных.
Каталог данных полезен, когда работает с актуальным ландшафтом данных
В крупной организации почти никогда не бывает единого технологического стека. Транзакционные данные могут храниться в PostgreSQL, аналитика — в MPP-СУБД, отчёты — в нескольких BI-системах, загрузки — в Airflow и NiFi, а часть файлов — в HDFS или S3. Рядом с ними нередко работают системы 1С, приложения собственной разработки и решения, которые создавались под отдельные задачи. Пользователю не так важно, в какой именно системе находится нужный объект. Ему нужно быстро ответить на прикладные вопросы: где лежат данные о клиенте, из чего рассчитывается показатель, какой процесс обновляет витрину, кто отвечает за качество и какие отчёты затронет изменение поля. Для этого каталог должен видеть не отдельные сущности, а то, как они связаны между собой.
Коннекторы формируют именно такой интеграционный слой. Они не заставляют компанию переносить данные в одно хранилище или менять уже работающие системы. Каталог объединяет их на уровне метаданных: описаний, структуры, зависимостей, владельцев, статусов и бизнес-контекста.
Коннекторы формируют именно такой интеграционный слой. Они не заставляют компанию переносить данные в одно хранилище или менять уже работающие системы. Каталог объединяет их на уровне метаданных: описаний, структуры, зависимостей, владельцев, статусов и бизнес-контекста.
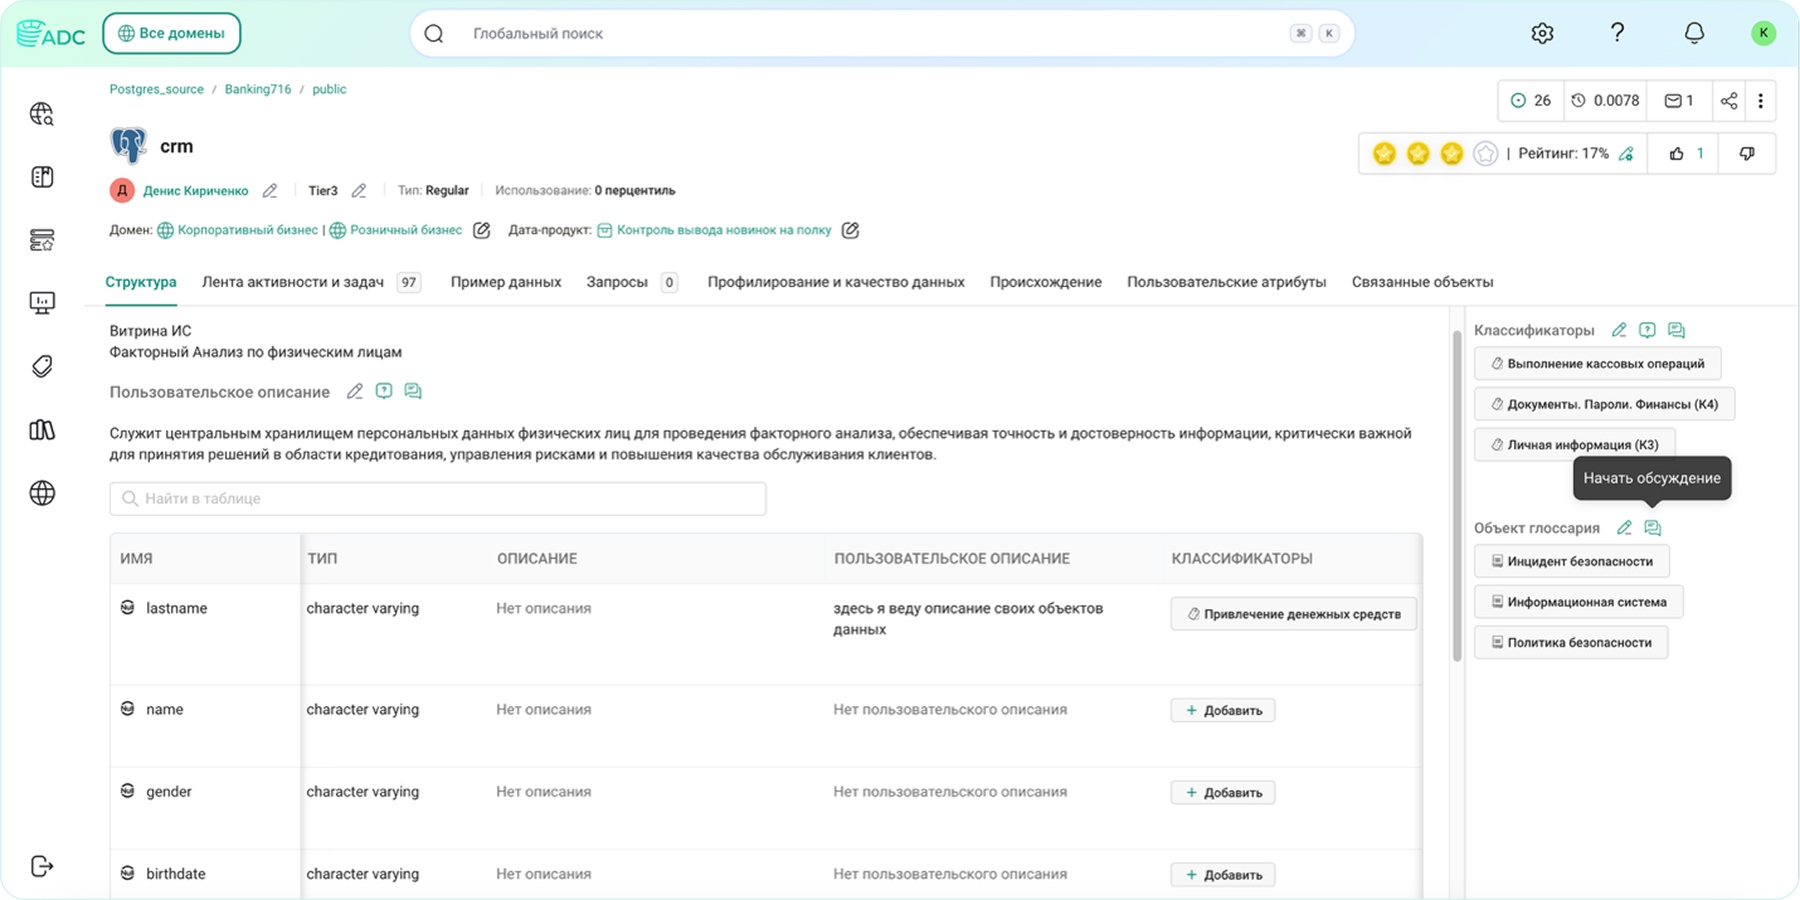
Пример результата автоматического сканирования структуры таблицы Postgres
Что именно делает коннектор
Коннектор — это программный модуль Arenadata Catalog, который подключается к источнику данных, считывает из него доступные метаданные и передаёт их в каталог данных. Состав информации зависит от типа источника. Для СУБД это могут быть схемы, таблицы, столбцы, типы данных, ключи, представления и процедуры. Для BI-платформ — модели, наборы данных, дашборды, чарты и показатели. Для систем оркестрации — DAG’и, задачи и связи между этапами обработки.
Важно не путать коннектор каталога с инструментами переноса и трансформации данных. В типовом сценарии использования в Arenadata Catalog поступают прежде всего сведения о данных (или метаданные), а не сами корпоративные массивы. При этом отдельные коннекторы могут получать примеры строк (иногда их называют «семпл-данные»), выполнять профилирование и рассчитывать статистику таблицы, если это предусмотрено функциональностью источника и политикой доступа заказчика.
Важно не путать коннектор каталога с инструментами переноса и трансформации данных. В типовом сценарии использования в Arenadata Catalog поступают прежде всего сведения о данных (или метаданные), а не сами корпоративные массивы. При этом отдельные коннекторы могут получать примеры строк (иногда их называют «семпл-данные»), выполнять профилирование и рассчитывать статистику таблицы, если это предусмотрено функциональностью источника и политикой доступа заказчика.
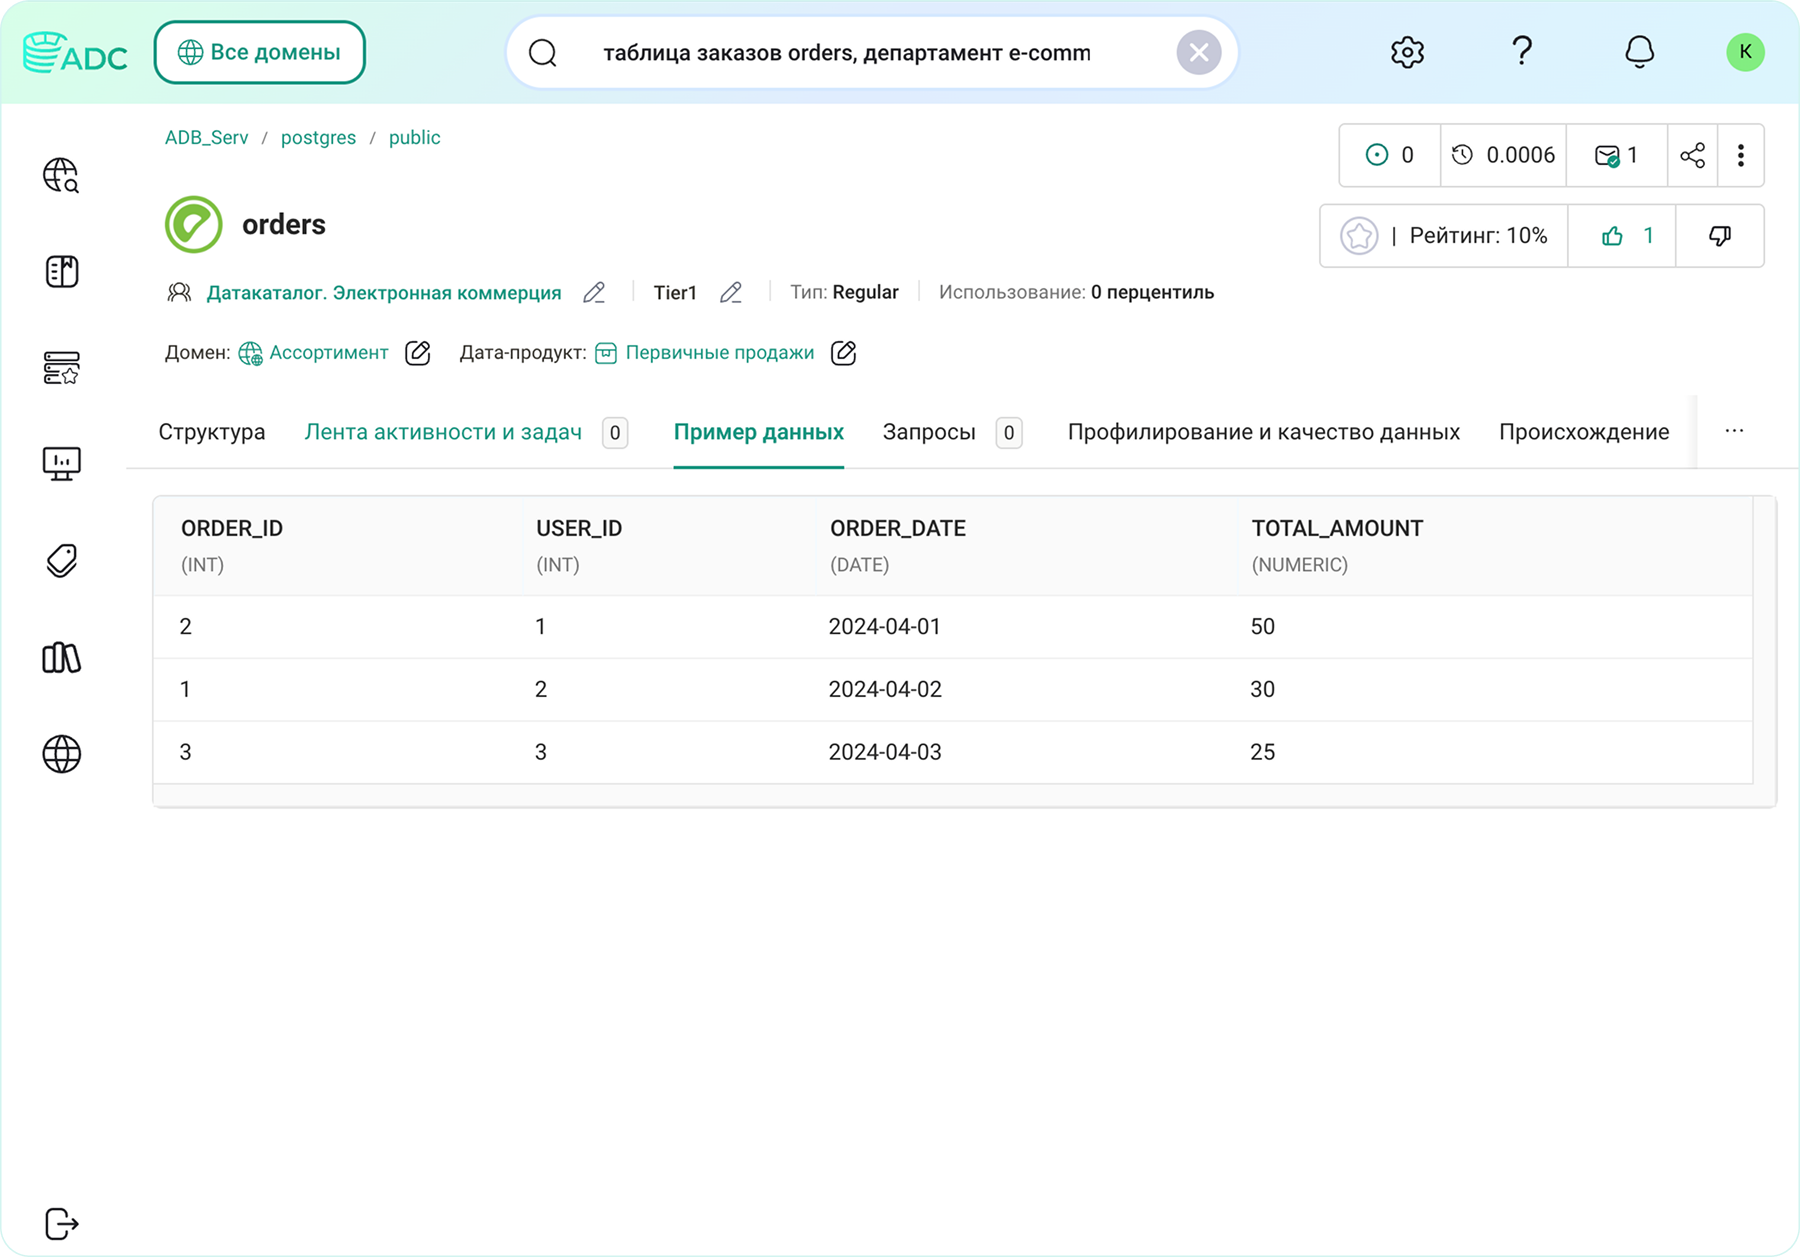
Пример отображения семпла данных таблицы СУБД ADB Greenplum
После сканирования объекты из разных систем попадают в единую модель. Каталог может связать таблицу в СУБД с процессом её обновления, витриной, BI-дашбордом и термином бизнес-глоссария. Именно этот процесс превращает набор технических описаний в рабочую карту данных.
Какие задачи решают коннекторы
Автоматическая инвентаризация
Коннекторы снимают фактическую структуру источников и регулярно обновляют её в каталоге. Команде не приходится вручную заводить сотни таблиц, полей и отчётов или поддерживать параллельный реестр в Excel. Так после сканирования новые объекты появляются в каталоге, изменённые данные актуализируются, а удалённые можно выявить и обработать по принятому регламенту.
Построение Data Lineage
Одного списка объектов недостаточно, так как пользователям нужно понимать путь данных: откуда они пришли, какие преобразования прошли и где используются. Arenadata Catalog объединяет метаданные СУБД, ETL- и ELT-процессов, оркестраторов и BI-систем в сквозной граф Data Lineage. Он помогает не только объяснить происхождение показателя, но и заранее оценить последствия изменений.
Как отмечает Алексей Никитин, генеральный директор Visiology, у Data Lineage две ключевые задачи: понять, откуда появилась конкретная цифра, и оценить последствия изменений. Обе невозможно полноценно решить, если цепочка заканчивается на витрине и не доходит до BI. «Бизнес-пользователь работает не с таблицами в хранилище — он видит показатель на дашборде и принимает на его основе решение. Поэтому ему важно понимать происхождение именно этой цифры: из каких источников она получена, какие преобразования прошла, по какой формуле рассчитана и какие фильтры на неё повлияли».
Как отмечает Алексей Никитин, генеральный директор Visiology, у Data Lineage две ключевые задачи: понять, откуда появилась конкретная цифра, и оценить последствия изменений. Обе невозможно полноценно решить, если цепочка заканчивается на витрине и не доходит до BI. «Бизнес-пользователь работает не с таблицами в хранилище — он видит показатель на дашборде и принимает на его основе решение. Поэтому ему важно понимать происхождение именно этой цифры: из каких источников она получена, какие преобразования прошла, по какой формуле рассчитана и какие фильтры на неё повлияли».
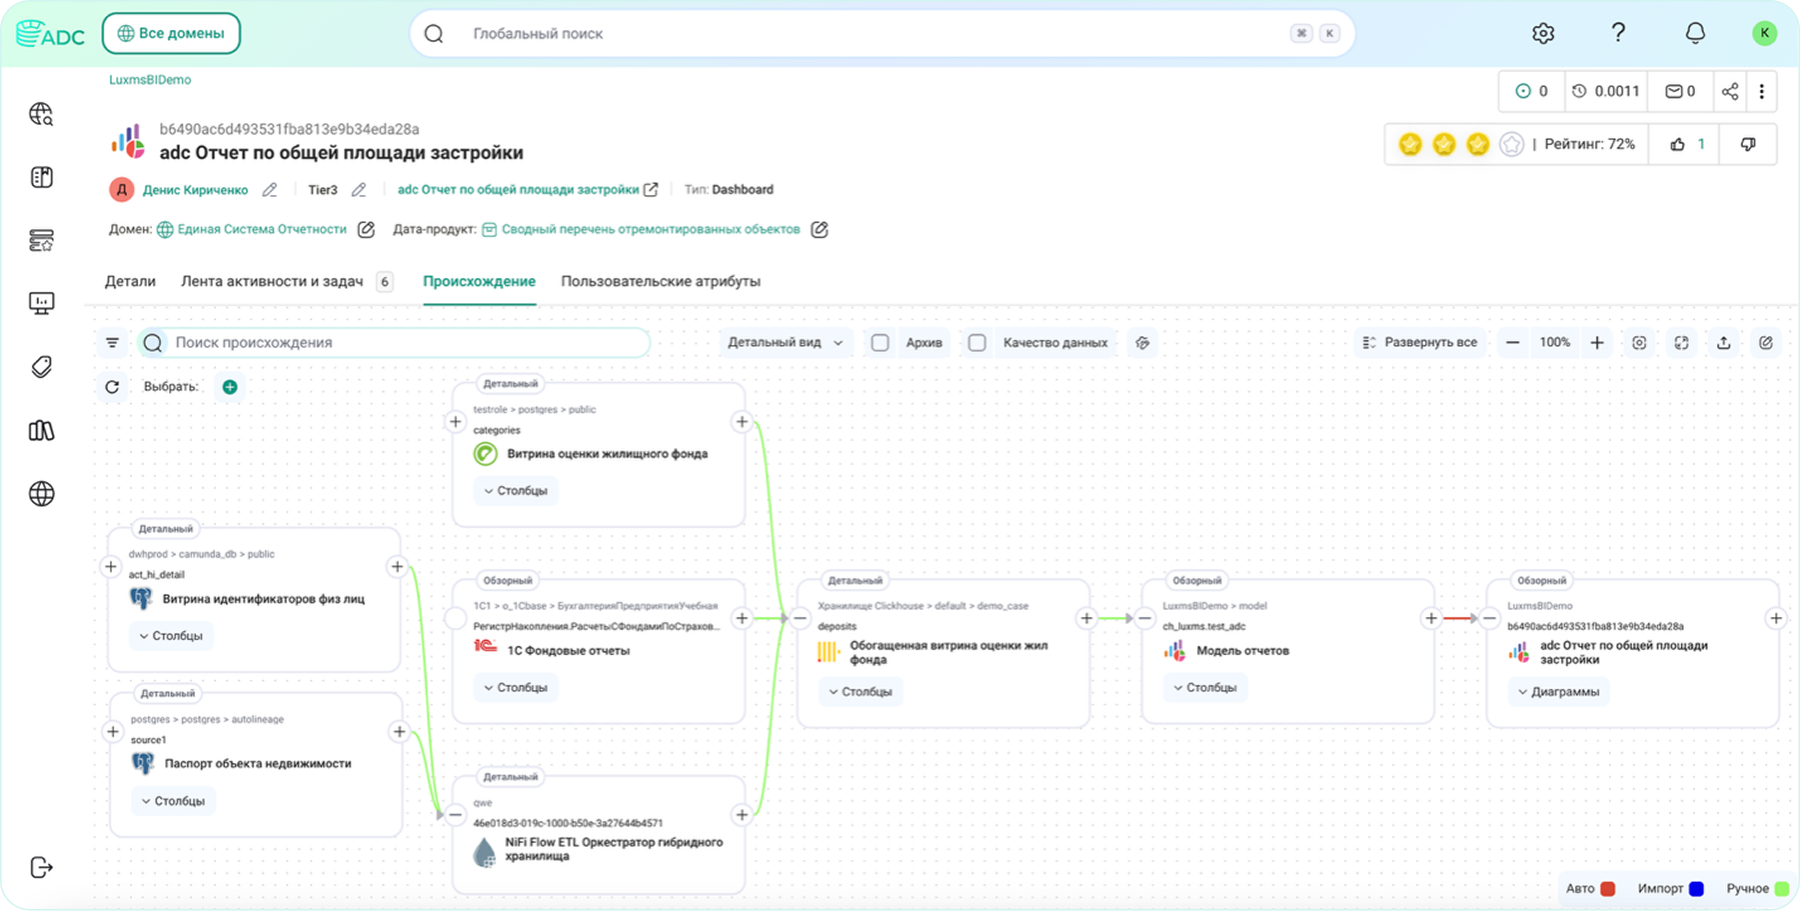
Сквозной Data Lineage потоков данных информационных систем 1С, СУБД Greenplum, Postgres и ClickHouse, использующихся для построения аналитического дашборда
Профилирование и понимание содержимого
Для ряда источников коннекторы позволяют получать примеры данных и результаты профилирования: заполненность, уникальность, распределение значений и другие характеристики. Это помогает быстрее понять назначение неизвестной таблицы, обнаружить проблемы качества и выбрать подходящий набор данных.
Связь технического и бизнес-уровня
Собранные объекты можно связывать с глоссарием, владельцами, командами и регламентами. Благодаря этому бизнес-пользователь видит не только название столбца, но и его понятное определение, а дата-инженер — ответственного и перечень отчётов, которые зависят от объекта.
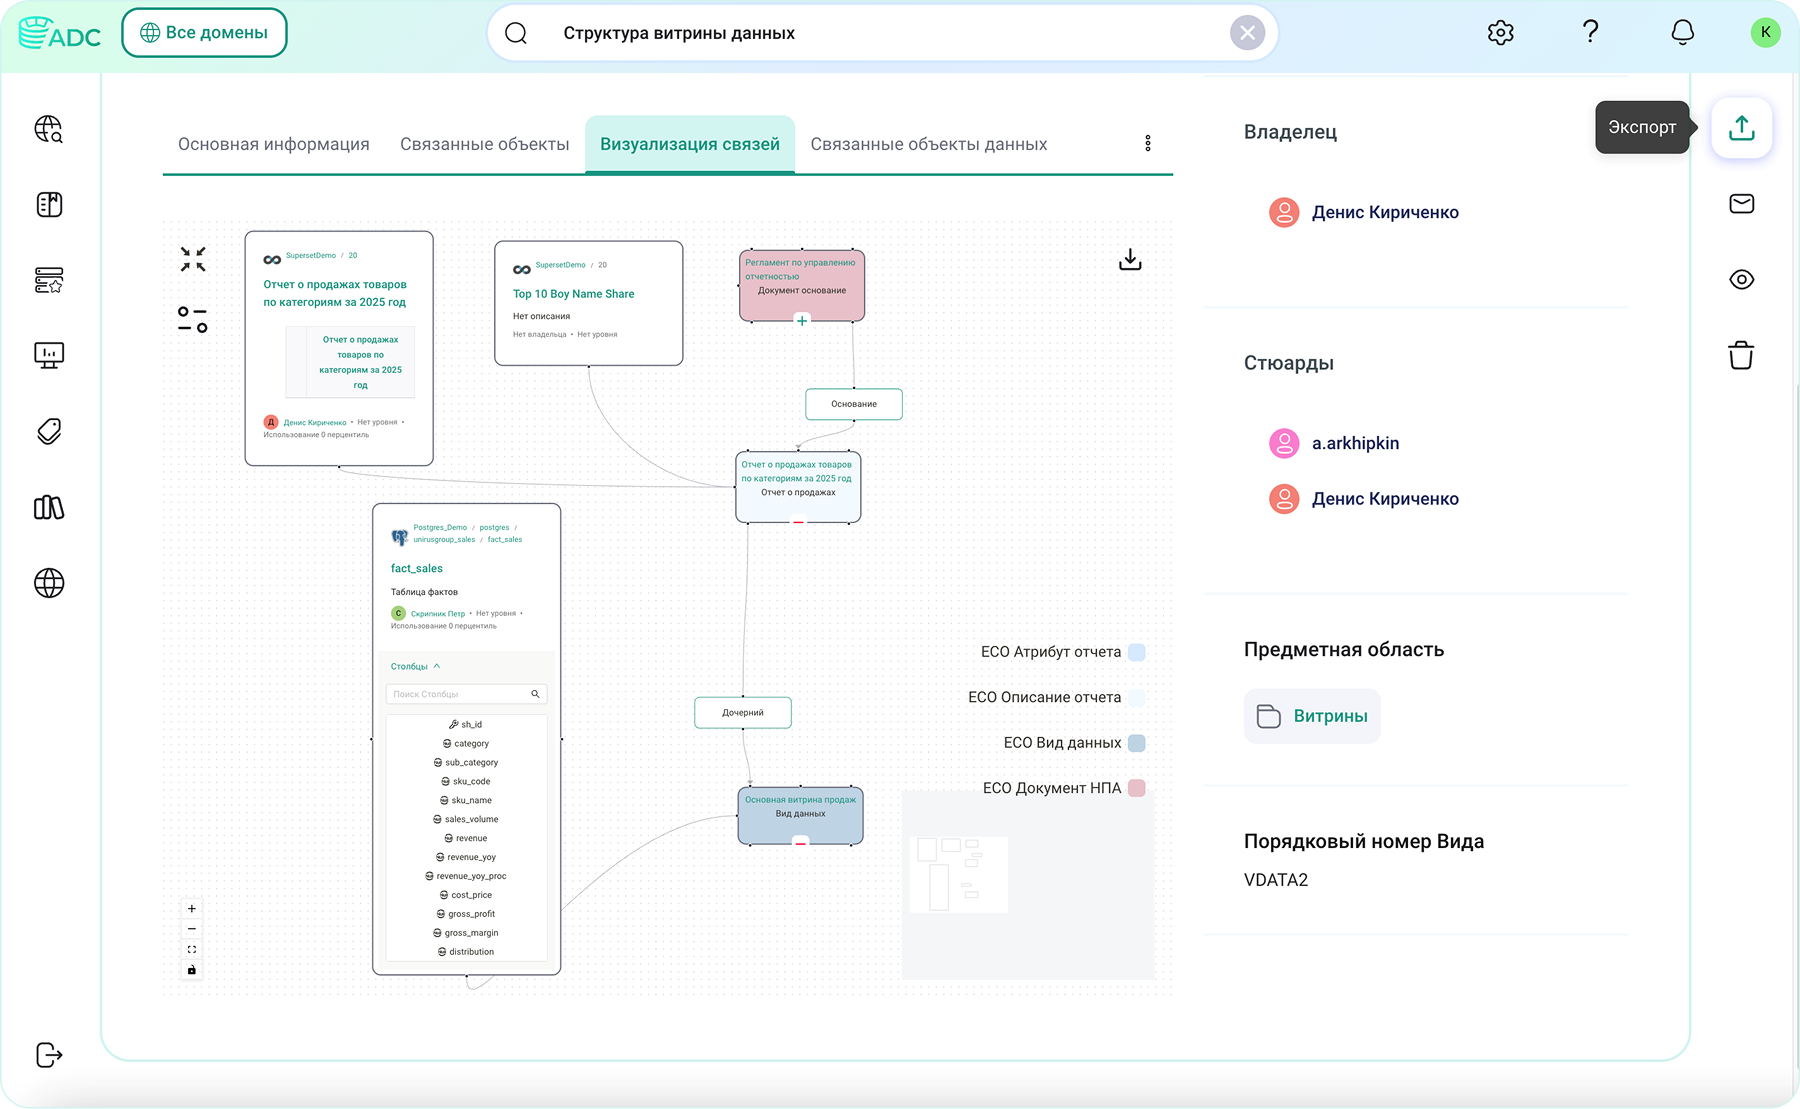
Визуализация связи технического и бизнес-уровня на примере витрины данных
Актуальность документации
Ручная документация устаревает сразу после первого изменения в системе. Автоматическое сканирование по расписанию позволяет регулярно сверять каталог с фактической структурой источников: новые объекты добавляются, изменения в существующих фиксируются, а удалённые можно своевременно выявить. Так снижается риск того, что документация разойдётся с реальной инфраструктурой, а каталог остаётся живой моделью, которая меняется вместе с ней.
В каких ситуациях необходимы коннекторы
1. Когда в компании много разнородных источников.
В современных реалиях ручная каталогизация становится пережитком прошлого. Без автоматизированного сбора метаданных каталогизация растягивается на месяцы и начинает зависеть от того, насколько аккуратно каждая команда ведёт собственные описания.
2. Если сотрудники не понимают, где искать нужные данные и откуда берутся цифры в отчётах.
Коннекторы позволяют пройти цепочку от дашборда до исходных таблиц и увидеть, какие данные применяются в том или ином отчёте.
3. В случае если ландшафт быстро меняется.
Компания запускает новые платформы, добавляет дата-продукты, развивает lakehouse или подключает новые BI-инструменты. С помощью коннектора новый источник можно включить в контур управления данными без ручного описания его структуры, а в дальнейшем обогащать собранные метаданные.
4. Когда в компании используются разные типы систем — вендорские решения, open source продукты и собственные разработки.
Каталог даёт единый способ работать с метаданными всех этих систем и не привязывает процессы управления данными к конкретному технологическому стеку.
Если речь идёт о редкой отраслевой или собственной системе, может потребоваться партнёрская или кастомная интеграция, но общий принцип остаётся тем же: данные не должны выпадать из корпоративной карты только потому, что источник нестандартный.
Семь классов источников: что можно подключить к Arenadata Catalog
Arenadata Catalog поддерживает автоматизированное сканирование метаданных более чем из 70 типов источников. Их можно разделить на семь крупных классов: базы данных, сервисы обмена сообщениями, BI-платформы, инструменты построения пайплайнов, сервисы машинного обучения, другие каталоги метаданных и файловые либо объектные хранилища.
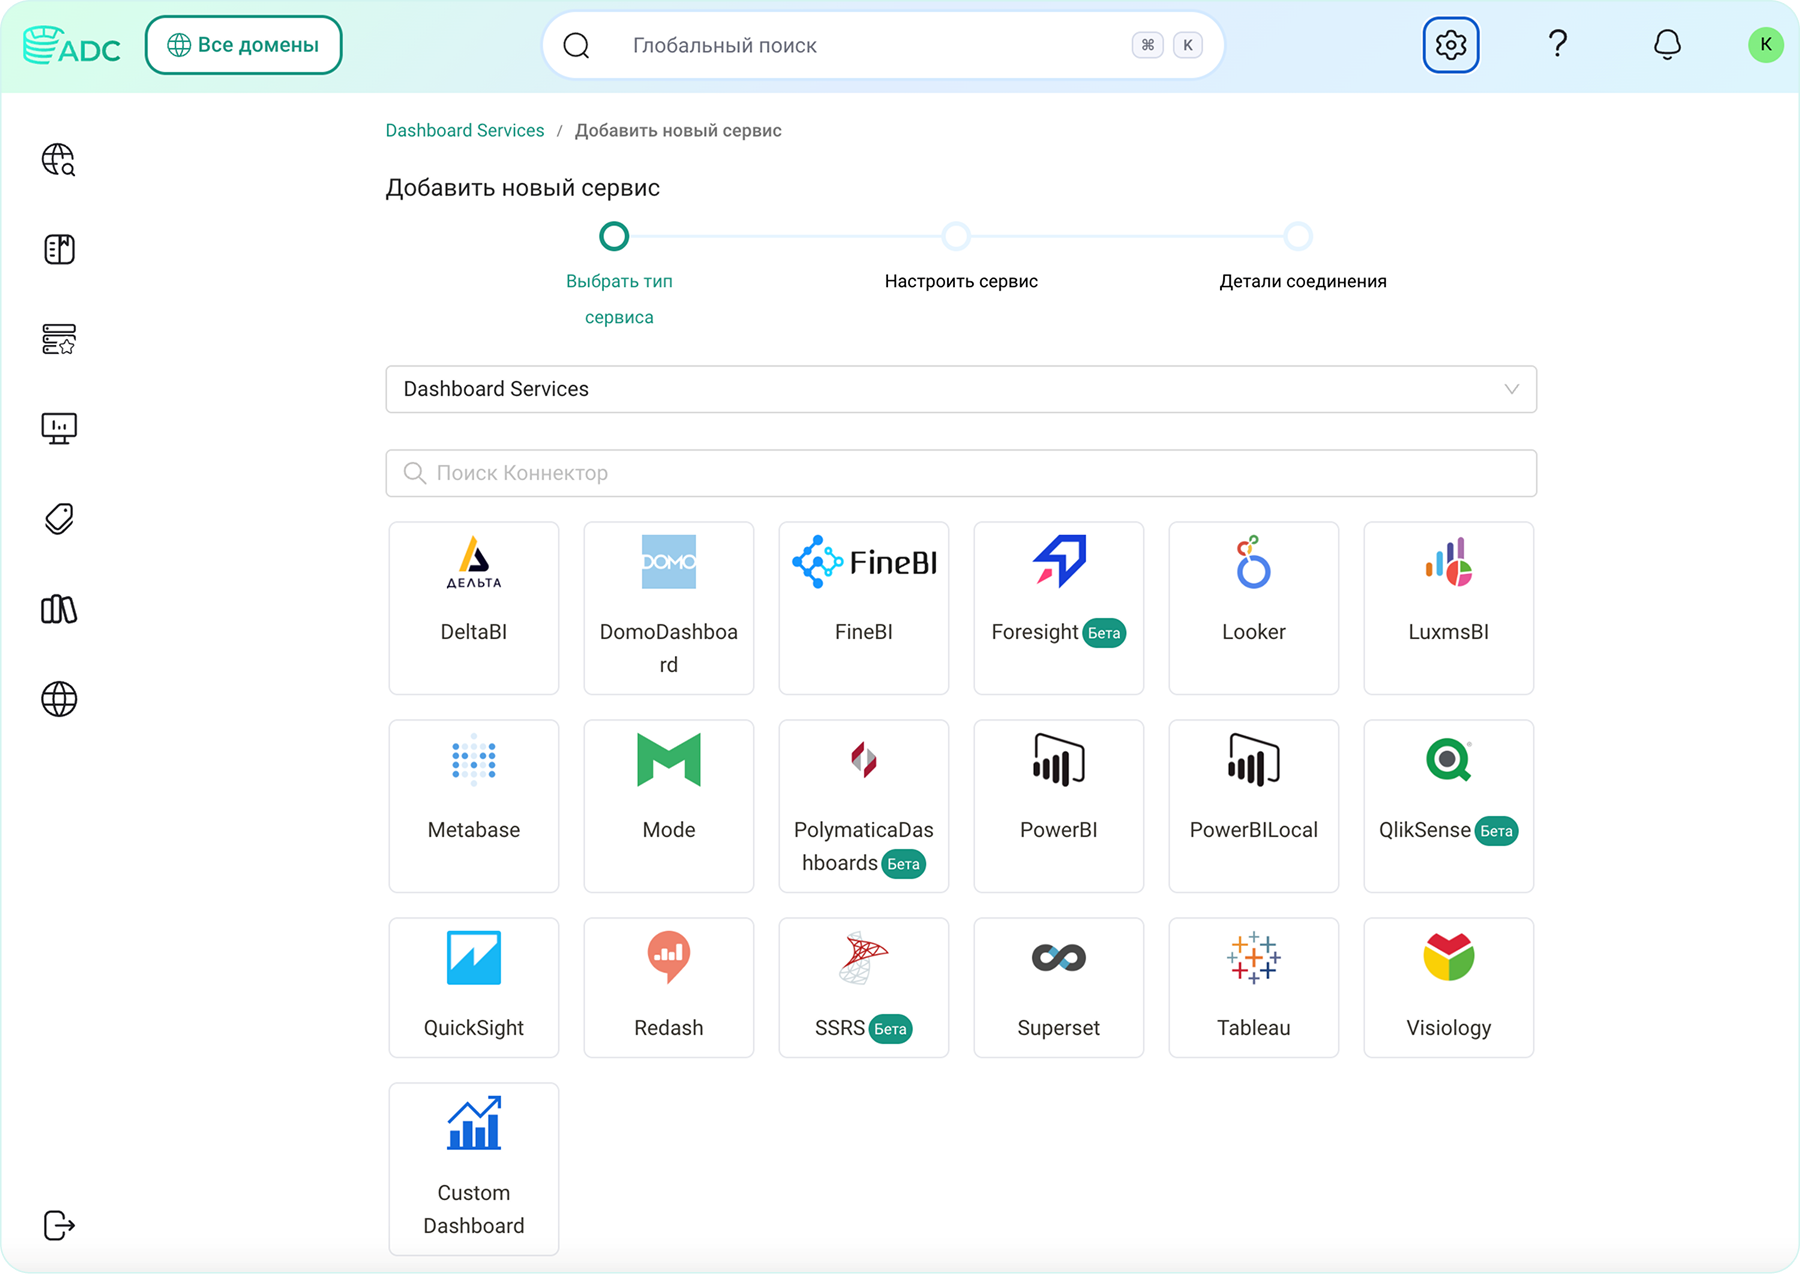
Интерфейс подключения сервисов сканирования источников класса BI-дашборд в Arenadata Catalog
Ниже несколько характерных коннекторов, которые показывают, как меняется их функциональность в зависимости от источника.
PostgreSQL и Arenadata Prosperity
Подробнее о Arenadata Prosperity.
PostgreSQL остаётся одним из самых распространённых источников транзакционных данных — на этой технологии, в частности, основана СУБД Arenadata Prosperity (ADP). Коннектор считывает структуру баз и схем, таблицы, столбцы, представления и другие технические объекты. На основе метаданных можно построить ER-диаграмму, получить примеры данных, выполнить профилирование и включить объекты в Data Lineage. В промышленных инсталляциях каталогов это один из базовых и наиболее востребованных сценариев.
Arenadata DB
Подробнее о Arenadata DB.
Для аналитических хранилищ Arenadata Catalog поддерживает сканирование СУБД Greengage, на основе которой построена СУБД Arenadata DB (ADB). Помимо стандартной структуры СУБД, коннектор умеет работать с PXF — механизмом подключения внешних источников. Анализ PXF позволяет автоматически фиксировать потоки и формировать связи между таблицами-источниками и таблицами-приёмниками, поэтому граф происхождения данных строится с минимальным ручным участием.
Visiology
Подробнее о Visiology.
BI-коннектор должен видеть не только физические источники, но и конечный слой аналитики. Коннектор к Visiology сканирует дашборды, чарты, типы визуализаций и их описания. Arenadata Catalog связывает модели и дашборды BI-системы с таблицами в базе данных, а объекты бизнес-глоссария с соответствующими чартами. Аналогичные сценарии реализуются для Luxms BI, Polymatica Dashboards, «Форсайт», Superset, Tableau и других популярных BI-платформ.
При этом глубина интеграции важнее самого факта наличия связи между BI и каталогом данных. Часть логики может находиться внутри BI-платформы: там объединяются источники, создаются расчётные таблицы и показатели, применяются связи и фильтры. В Visiology, например, аналитический движок «ДанКо» позволяет загружать и хранить данные, выполнять ETL-преобразования и создавать новые таблицы, а поверх модели рассчитываются меры и показатели на DAX. Поэтому полноценный Data Lineage должен охватывать не только внешнюю витрину, но и внутренние преобразования и логику конкретного дашборда
АЛЕКСЕЙ НИКИТИН,
генеральный директор Visiology.
генеральный директор Visiology.
Airflow
Коннектор к Airflow каталогизирует DAG’и и структуру процессов оркестрации. Это даёт возможность увидеть, какие задачи читают исходные данные, какие преобразования выполняют и какие наборы формируют на выходе. В общей карте Airflow связывает слой хранения с последующими витринами и отчётностью.
Arenadata Streaming
Подробнее о Arenadata Streaming.
В потоковом контуре важны не только конечные таблицы, но и маршруты передачи данных. Arenadata Catalog поддерживает сканирование NiFi и Kafka в составе Arenadata Streaming (ADS) и может включать процессоры и потоки в общую схему зависимостей. Так пользователь видит, каким путём информация проходит между источниками, очередями, обработчиками и системами-получателями.
MLflow
Каталогизация ML-сервисов помогает связать модели машинного обучения с наборами данных и процессами, на которых они основаны. Коннектор к MLflow позволяет включить объекты ML-контура в общую систему управления метаданными. Это особенно важно, когда модель используется в продуктивном процессе и необходимо понимать происхождение обучающих данных, версии артефактов и ответственных.
HDFS и S3
Файловые и объектные хранилища часто содержат большие объёмы данных, но их структура хуже видна бизнес-пользователям, в отличие от классической СУБД. Коннекторы к HDFS и S3 сканируют состав и иерархию объектов, после чего их можно искать, описывать, связывать с владельцами и включать в сквозной Data Lineage. Кроме того, Arenadata Catalog способен получать сведения из других каталогов метаданных, например Amundsen и Apache Atlas, если они уже присутствуют в инфраструктуре заказчика.
Как коннектор работает в пользовательском сценарии
Подключение источника не требует от пользователя вручную переносить его структуру в каталог. Типовой сценарий состоит из нескольких шагов.
1. В интерфейсе Arenadata Catalog активируется коннектор нужного типа и регистрируется источник.
2. Администратор задаёт параметры подключения и права доступа. Каталог получает только тот объём информации, который разрешён политикой безопасности.
3. Настраивается область сканирования, например конкретные базы, схемы, проекты, дашборды или хранилища. При необходимости задаются профилирование и получение примеров данных.
4. В планировщике определяется расписание. Сканирование может выполняться регулярно и обновлять каталог в соответствии с регламентом работы источника.
5. После запуска коннектор получает метаданные, преобразует их в модель Arenadata Catalog и создаёт или обновляет объекты.
6. Каталог сопоставляет сведения из разных систем и формирует связи от источника и пайплайна до витрины, показателя и дашборда.
2. Администратор задаёт параметры подключения и права доступа. Каталог получает только тот объём информации, который разрешён политикой безопасности.
3. Настраивается область сканирования, например конкретные базы, схемы, проекты, дашборды или хранилища. При необходимости задаются профилирование и получение примеров данных.
4. В планировщике определяется расписание. Сканирование может выполняться регулярно и обновлять каталог в соответствии с регламентом работы источника.
5. После запуска коннектор получает метаданные, преобразует их в модель Arenadata Catalog и создаёт или обновляет объекты.
6. Каталог сопоставляет сведения из разных систем и формирует связи от источника и пайплайна до витрины, показателя и дашборда.
Дальше с результатом работают разные пользователи. Например, аналитик ищет нужный набор и проверяет его происхождение, владелец данных дополняет объект бизнес-описанием и правилами и так далее. Коннектор в этом сценарии остаётся почти незаметным, но именно он поддерживает фактическую основу каталога.
Три модели подключения систем
Корпоративные ландшафты слишком разнообразны, чтобы каталог мог ограничиться одним способом интеграции. В Arenadata Catalog предусмотрены три модели, которые можно сочетать в рамках одного проекта.
Готовые коннекторы Arenadata Catalog
Коробочный коннектор подходит для распространённых СУБД, BI-платформ, инструментов обработки и других типовых компонентов. Это самый быстрый сценарий: компания регистрирует источник, настраивает доступ и запускает автоматический сбор метаданных. Готовая интеграция особенно полезна, когда нужно быстро начать инвентаризацию или включить новую систему в действующий контур Data Governance.
По нашему опыту, стандартных коннекторов обычно оказывается недостаточно в двух случаях: когда в инфраструктуре есть системы, для которых интеграции „из коробки“ не предусмотрены, и когда требуется более полная информация о Data Lineage. Встроенные механизмы lineage не всегда охватывают все зависимости, поэтому для полноценной картины происхождения данных может потребоваться отдельная интеграция
АЛЕКСАНДР СТУЛОВ,
директор проектов Sapiens solutions.
директор проектов Sapiens solutions.
Коннекторы, разработанные с партнёрами
Не все системы позволяют получить метаданные стандартным способом. Иногда для этого требуется глубокая экспертиза конкретной платформы, её внутренних объектов и ограничений. Показательный пример — коннектор к SAP BW, созданный командами Sapiens solutions и DataCatalog (входит в Группу Arenadata). SAP BW работает с абстрактными объектами, которые отсутствуют на физическом уровне таблиц и недоступны обычными SQL-запросами. Совместное решение извлекает их описания, источники данных и Data Lineage, а затем связывает с остальными объектами Arenadata Catalog, не вмешиваясь в ядро SAP BW.
В такой модели Arenadata отвечает за развитие каталога и его единую модель, а партнёр привносит предметную экспертизу по конкретной системе и особенностям ландшафта заказчика.
В такой модели Arenadata отвечает за развитие каталога и его единую модель, а партнёр привносит предметную экспертизу по конкретной системе и особенностям ландшафта заказчика.
Кастомные коннекторы заказчика
В инфраструктуре могут существовать собственная разработка, редкая отраслевая система или сильно изменённый legacy-продукт, для которого нет готового коннектора. В этом случае интеграцию можно построить с использованием публичных API и механизмов кастомизации Arenadata Catalog. Где-то достаточно загрузки подготовленных метаданных, где-то потребуется отдельный адаптер, а иногда анализ кода или журналов выполнения. Состав объектов, глубину автоматизации Lineage, требования к безопасности и модель сопровождения лучше определять на этапе проектирования. Главный принцип прост: компания должна иметь возможность встроить каталог в реальный ИТ-ландшафт, а не перестраивать весь ландшафт ради каталога.
Александр Стулов отмечает, что при разработке таких коннекторов одна из ключевых задач — сопоставить специфику конкретной системы с единой моделью Arenadata Catalog. «Модель каталога по определению усредняет устройство разных ИТ-систем, поэтому при интеграции иногда приходится искать компромисс. Например, для СУБД в ADC предполагается иерархия „база данных — схема — таблица — колонка“, но в некоторых системах слой схемы может отсутствовать. Для BI-систем похожая ситуация возникает с папками, в которых расположены отчёты: если модель каталога не предусматривает их как отдельный уровень иерархии, эту информацию приходится сохранять в описании или дополнительном атрибуте», — говорит директор проектов Sapiens solutions.
Поэтому оценивать интеграционные возможности каталога только по общему числу коннекторов недостаточно. Важнее, закрывает ли конкретный набор реальный ландшафт компании и даёт ли нужную глубину метаданных.
По оценке Алексея Никитина, максимальную практическую ценность связка BI с каталогом данных получает в крупных зрелых средах, где существуют сотни и тысячи источников, витрин, моделей и отчётов. В таком масштабе зависимости уже невозможно удерживать в голове или передавать через личные договорённости — нужны формализованное описание, автоматизированный Data Lineage и анализ влияния изменений. Для небольшого ландшафта с несколькими основными источниками отдельная сложная система управления метаданными может быть избыточной.
Александр Стулов отмечает, что при разработке таких коннекторов одна из ключевых задач — сопоставить специфику конкретной системы с единой моделью Arenadata Catalog. «Модель каталога по определению усредняет устройство разных ИТ-систем, поэтому при интеграции иногда приходится искать компромисс. Например, для СУБД в ADC предполагается иерархия „база данных — схема — таблица — колонка“, но в некоторых системах слой схемы может отсутствовать. Для BI-систем похожая ситуация возникает с папками, в которых расположены отчёты: если модель каталога не предусматривает их как отдельный уровень иерархии, эту информацию приходится сохранять в описании или дополнительном атрибуте», — говорит директор проектов Sapiens solutions.
Поэтому оценивать интеграционные возможности каталога только по общему числу коннекторов недостаточно. Важнее, закрывает ли конкретный набор реальный ландшафт компании и даёт ли нужную глубину метаданных.
По оценке Алексея Никитина, максимальную практическую ценность связка BI с каталогом данных получает в крупных зрелых средах, где существуют сотни и тысячи источников, витрин, моделей и отчётов. В таком масштабе зависимости уже невозможно удерживать в голове или передавать через личные договорённости — нужны формализованное описание, автоматизированный Data Lineage и анализ влияния изменений. Для небольшого ландшафта с несколькими основными источниками отдельная сложная система управления метаданными может быть избыточной.
Что получает заказчик
Главный результат — единая и регулярно обновляемая карта корпоративных данных. Пользователи находят нужные наборы через один интерфейс, видят их происхождение и назначение, а ИТ-команды могут анализировать влияние изменений и быстрее анализировать ошибки.
Практический эффект хорошо виден на примере использования Arenadata Catalog в «Комусе». Вместе с командой клиента эксперты Sapiens solutions разработали уникальные интеграционные решения, которые позволили максимально автоматизировать сбор метаданных и формирование Data Lineage. В рамках проекта были созданы специальные инструменты, которые обеспечили стабильную выгрузку описаний из сложных аналитических систем, таких как Business Objects, и связали их с физическими источниками данных. Благодаря этому удалось избежать ручного труда и быстро наполнить Arenadata Catalog необходимым контентом. При этом «Комус» успешно применяет стандартные коробочные коннекторы Arenadata Catalog для подключения к типовым источникам метаданных.
Этот кейс показывает эффективность применения всех трёх подходов к сканированию систем источников. Коробочные коннекторы закрывают типовые источники, партнёрские решения помогают работать со сложными корпоративными системами, а кастомизация позволяет не оставлять за пределами каталога уникальную логику конкретной компании.
Практический эффект хорошо виден на примере использования Arenadata Catalog в «Комусе». Вместе с командой клиента эксперты Sapiens solutions разработали уникальные интеграционные решения, которые позволили максимально автоматизировать сбор метаданных и формирование Data Lineage. В рамках проекта были созданы специальные инструменты, которые обеспечили стабильную выгрузку описаний из сложных аналитических систем, таких как Business Objects, и связали их с физическими источниками данных. Благодаря этому удалось избежать ручного труда и быстро наполнить Arenadata Catalog необходимым контентом. При этом «Комус» успешно применяет стандартные коробочные коннекторы Arenadata Catalog для подключения к типовым источникам метаданных.
Этот кейс показывает эффективность применения всех трёх подходов к сканированию систем источников. Коробочные коннекторы закрывают типовые источники, партнёрские решения помогают работать со сложными корпоративными системами, а кастомизация позволяет не оставлять за пределами каталога уникальную логику конкретной компании.
Живая карта вместо статичного реестра
ИТ-ландшафт неизбежно меняется: появляются новые источники, команды создают витрины и дашборды, обновляют пайплайны и запускают ML-модели. Каталог, который наполняется вручную, довольно быстро начинает устаревать. Коннекторы позволяют ему оставаться синхронизированным с реальностью. Именно поэтому интеграции — основа практической ценности каталога данных. Они соединяют разнородные технологии на уровне метаданных, делают происхождение данных прозрачным и превращают корпоративный ландшафт из набора отдельных систем в управляемую карту. Чем точнее эта карта отражает фактическую инфраструктуру, тем увереннее компания может развивать аналитику, качество данных, Data Governance и новые ИИ-сценарии.